Blog
Khronos: la paleografía que nos falta y la que la IA puede dar
Sabemos poco de Costa Rica entre 1500 y 1821, pero no porque falten documentos. Faltan lectores. Los protocolos de los escribanos, las actas de cabildo, los libros parroquiales y los expedientes de la Audiencia existen; están en el Archivo Nacional, en el Archivo General de Centro América y en microfilm. Lo que no existe es la capacidad de leerlos: la paleografía, el oficio de descifrar escrituras antiguas, se enseña a pocas personas, se aprende en años y se ejerce a razón de una página a la vez. Hay más folios que paleógrafos tendrán tiempo de leer en su vida.
Khronos es un proyecto personal que nació de esa cuenta que no cierra. La pregunta no era si una inteligencia artificial puede reemplazar a un paleógrafo, sino si puede aportar la capacidad que ningún humano tiene: leer decenas de miles de páginas sin cansarse, a un costo marginal, con el contexto de tres siglos cargado en la memoria. Un primer resultado está en basetlabs.com/khronos: un mapa, una cronología y una red de personas construidos a partir de 11 053 registros notariales y de un manuscrito de 1617. El código y los datos están en GitHub. Esta entrada cuenta hasta dónde llega hoy esa capacidad, dónde se rompe y cómo se construye lo que falta.
Una tarea que pide más que un humano
Leer un documento colonial no es leer. Es reconocer una mano procesal donde las letras se encadenan sin levantar la pluma, expandir abreviaturas que cambian de escribano en escribano, saber que «v.ro» es vecino y que «ss.no» es escribano, reconocer una fórmula de apertura para saltarla y una excepción para detenerse, tener presente quién era alcalde ese año y dónde quedaba Pacaca. Y luego hacerlo otra vez en la página siguiente, y en las diez mil que siguen, con la misma atención en la última que en la primera.
Un paleógrafo experto hace todo eso mejor que cualquier máquina actual. Lo que no puede hacer es escalarlo. La tarea pide, al mismo tiempo, pericia y volumen, y esas dos cosas casi nunca vienen juntas en una persona. Ahí es donde un modelo de lenguaje aporta un elemento genuinamente más que humano, aunque no sea el que suele imaginarse: no es más listo que el paleógrafo, pero no se cansa, no cobra por hora, lee en cualquier idioma y llega a cada página con todo lo que ha leído sobre la época. La pregunta útil es qué parte del oficio ya puede delegarse a esa capacidad y qué parte sigue siendo irreductiblemente humana.
Khronos la contestó en dos niveles de dificultad.
Primer nivel: leer a través del ruido
El primer nivel no es un manuscrito, sino un libro impreso que ya resume manuscritos: el Índice de los Protocolos de Cartago, publicado por los Archivos Nacionales de Costa Rica a inicios del siglo XX. Entrada por entrada, condensa los protocolos de los escribanos de Cartago: poderes, ventas, testamentos, obligaciones de pago, dotes, cartas de libertad. Cada entrada trae el folio, la fecha y un párrafo con las personas, los lugares y el asunto. Es una fuente de primer orden para la genealogía y la historia social colonial, pero solo se puede leer de corrido.
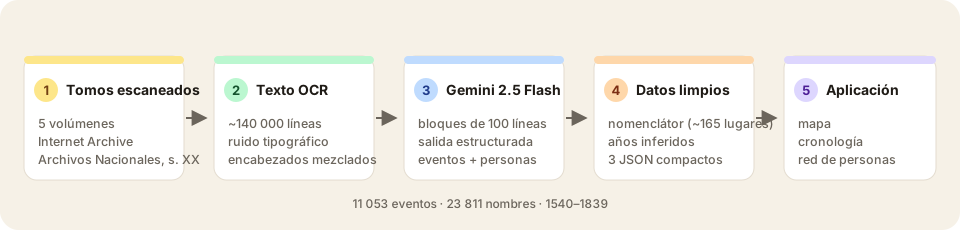
Partí de los cinco tomos digitalizados en Internet Archive. El texto OCR tiene cerca de 140 000 líneas y arrastra el ruido de una impresión antigua: letras cambiadas, acentos convertidos en números, encabezados de página mezclados con el contenido. Un humano lee a través de ese ruido sin darse cuenta; una expresión regular no. Un modelo de lenguaje, sí.
Un script en Python divide el texto en bloques de 100 líneas y envía cada bloque a Gemini 2.5 Flash con un esquema Pydantic que describe lo que quiero de vuelta: una lista de eventos (año, día y mes, lugares, personas involucradas y un resumen de dos o tres frases) y una lista de perfiles de personas (nombre, rol u oficio, edad o nacimiento inferido y relaciones con otras personas del bloque).
1 En.  24—El Capitán Francisco de Ocampo Golfín;, enco
mendero de esta ciudad, da poder general 4 Gó-
mez Arias, procurador de causas en la Audiencia
de Guatemala.
{
  "year": "1607",
  "date": "Jan 24",
  "locations": ["Cartago", "Guatemala"],
  "people_involved": [
    "Capitán Francisco de Ocampo Golfín",
    "Gómez Arias"
  ],
  "summary_es": "El Capitán Francisco de Ocampo
    Golfín, encomendero de Cartago, otorgó
    poder general a Gómez Arias, procurador
    en la Audiencia de Guatemala."
}
Aquí la capacidad ya es sobrehumana en el eje que importa: el volumen. Ninguna persona habría fichado 140 000 líneas con ese nivel de detalle; el modelo lo hizo en un proceso que corre solo, con reintentos y progreso guardado en disco para que una interrupción no obligue a empezar de cero, y una segunda pasada en lotes de 50 eventos tradujo los resúmenes al español. El resultado: 11 053 eventos y 23 811 nombres de personas distintos, de cinco tomos que hasta entonces solo se podían hojear.
Los cinco tomos, digitalizados en Internet Archive:
- Índice de los Protocolos de Cartago, Tomo I
- Índice de los Protocolos de Cartago, Tomo II
- Índice de los Protocolos de Cartago, Tomo III
- Índice de los Protocolos de Cartago, Tomo IV
- Índice de los Protocolos de Cartago, Tomo V
Lo que el modelo no sabe
La parte humana del oficio reapareció enseguida, pero en otro lugar: no en la lectura, sino en el contexto. Un segundo script convierte la salida del modelo en tres archivos JSON compactos, y ahí se resuelve lo que la lectura sola no resuelve:
- Años faltantes. Solo 4 294 eventos traen el año explícito. Como el índice es cronológico, los 6 759 restantes heredan el año del registro fechado anterior y se marcan con el símbolo ≈ en la interfaz. Es lo que haría un lector humano sin pensarlo; el modelo, bloque a bloque, no tiene esa memoria.
- Geografía colonial. Ningún modelo sabe dónde quedaba Pacaca o Landecho. Construí un nomenclátor de unos 165 lugares con sus coordenadas (el Valle Central, Guanacaste y el Pacífico, el Reino de Guatemala, España) y una tabla de alias que ignora acentos y grafías antiguas. Con eso, 6 645 eventos quedan ubicados en el mapa y 4 408 siguen sin coordenadas, casi siempre porque mencionan fincas, ríos o parajes que no he logrado identificar. Fue la parte más lenta del proyecto y la que más valor aporta.
| Indicador | Valor |
|---|---|
| Eventos extraídos | 11 053 |
| Con año explícito / inferido | 4 294 / 6 759 |
| Ubicados en el mapa | 6 645 |
| Nombres de personas distintos | 23 811 |
| Lugares en el nomenclátor | ~165 |
La lección del primer nivel: con un esquema claro, el modelo absorbe el trabajo tedioso de leer texto ruidoso a escala, y el esfuerzo humano se desplaza a validar, completar y decir lo que no se sabe. Los años inferidos se marcan, los lugares sin coordenadas se cuentan y el pie de página advierte que la extracción asistida por IA puede contener errores.
Segundo nivel: el manuscrito
El índice era letra impresa. La verdadera prueba de paleografía era un manuscrito, y elegí uno difícil a propósito: el Libro Once de Cabildo del Ayuntamiento de Santiago de Guatemala, las actas de 1617 a 1626, porque Costa Rica dependía de esa Audiencia y porque es un caso límite. Son 208 imágenes de microfilm del Archivo General de Centro América (A1, legajo 1773, expediente 11767), casi todas pliegos de dos páginas, en escritura procesal encadenada. El rollo digitalizado está en Internet Archive.
Un script nuevo envía cada imagen a Gemini 3.1 Pro con un esquema parecido al del índice: transcripción diplomática de cada página, notas marginales, lista de asuntos fechados con personas y lugares, y una estimación de legibilidad. Es reanudable, anota lo que cuesta cada página y se detiene al llegar a un presupuesto. El resultado está en la aplicación como una segunda colección: 504 asuntos, cada uno con su hoja, su folio y la legibilidad que el modelo le asignó a la página.
| Indicador | Valor |
|---|---|
| Imágenes de microfilm | 208 |
| Páginas leídas | 413 |
| Asuntos extraídos | 504 |
| Páginas con legibilidad estimada ≥ 0,7 | 96 |
| Costo del libro completo, una vez afinado | menos de 4 dólares |
Léase bien la última fila. Un libro de cabildo de diez años, en procesal, leído de principio a fin por menos de cuatro dólares. Esa es la dimensión económica de la capacidad más que humana: a ese precio, el límite para leer un archivo entero deja de ser el presupuesto. Pero el manuscrito dejó dos lecciones que el índice impreso no había dado, y la segunda es la que define dónde está hoy la frontera.
El costo se dispara en silencio. La primera pasada usaba temperatura 0,1, la misma que había funcionado con el índice. Con Gemini 3 esa temperatura provoca bucles de repetición: el modelo empieza a transcribir, entra en un ciclo y sigue generando hasta su límite de salida, y cada token se cobra. Cincuenta hojas costaron 35 dólares antes de que entendiera por qué. Con temperatura 1,0 y un tope de tokens de salida, una página cuesta dos centavos y el libro entero menos de cuatro dólares.
Una lectura fluida no es una lectura. Para medir la calidad sin un paleógrafo a mano, releí las mismas páginas varias veces y comparé las transcripciones entre sí. Dos lecturas de la misma página coinciden en una de cada diez palabras, también en las páginas que el modelo valora con 0,95 de legibilidad y también enviando cada página sola a plena resolución. Lo que el modelo sabe sale igual en todas las lecturas: las fórmulas de apertura, las fechas, la estructura de un acta. Lo que el modelo tiene que ver cambia en cada una: los nombres de los capitulares. Un modelo más barato llegó a inventar un cabildo entero con nombres verosímiles de la época, incluido el conde de la Gomera, que sí era presidente de la Audiencia en esas fechas y por eso resultaba creíble.
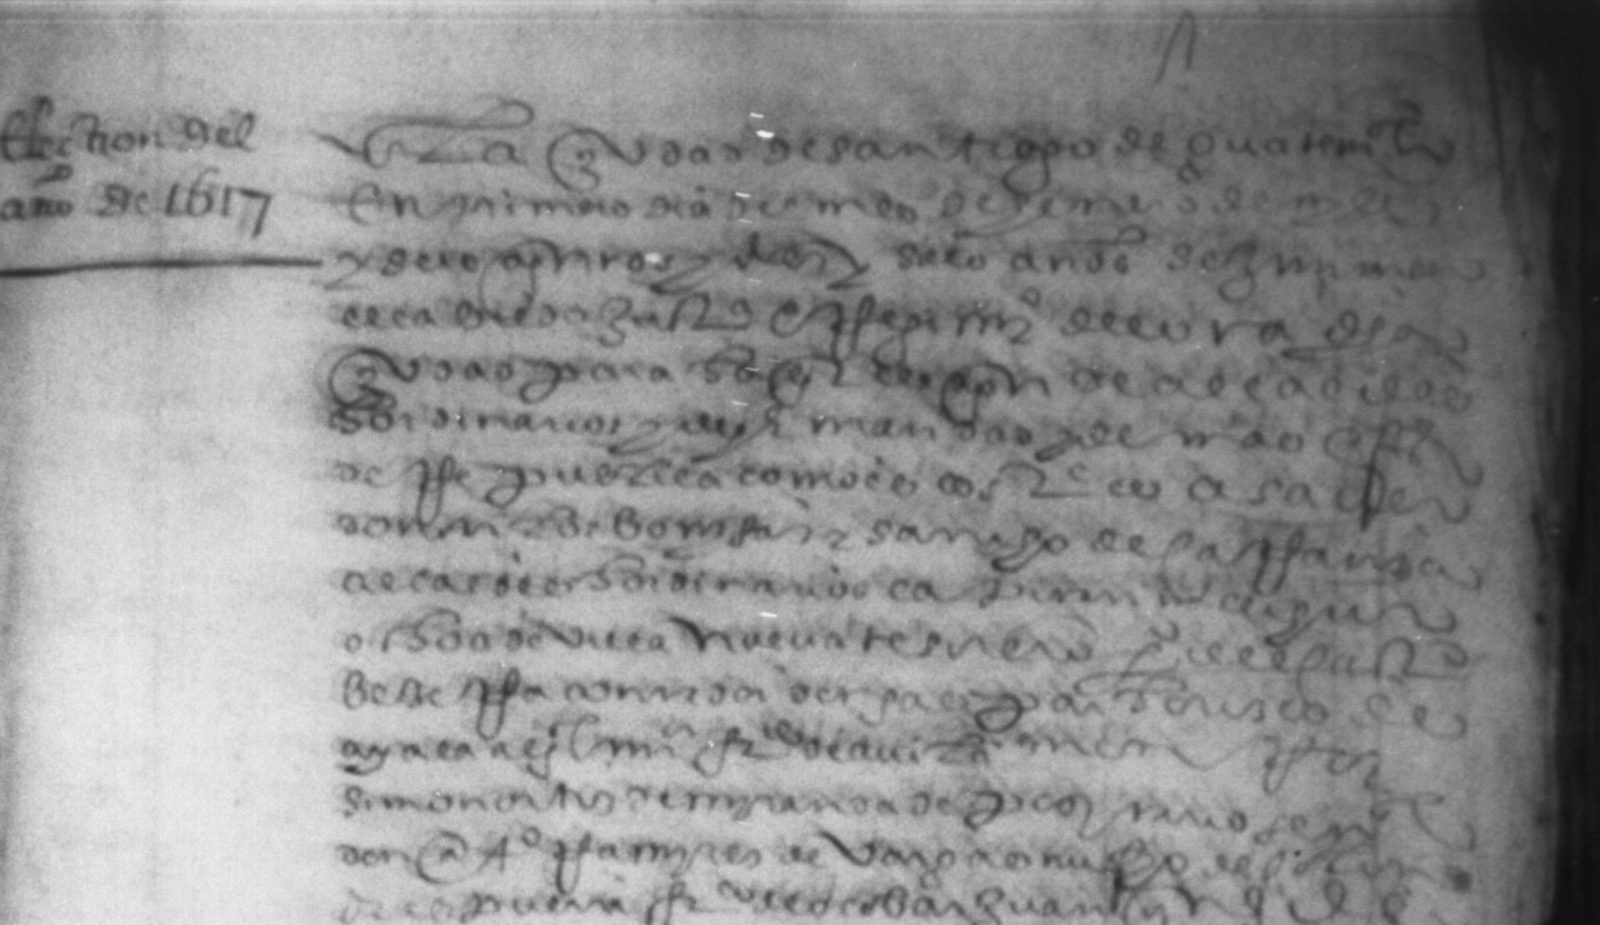
Esto es exactamente lo contrario de lo que hace un paleógrafo novato, que descifra las letras pero no entiende el documento. El modelo entiende el documento y no descifra las letras. Su «superinteligencia» es de contexto, no de vista: llega a la página sabiendo qué es un cabildo, cómo se abre un acta, quién gobernaba la Audiencia, y rellena con esa cultura lo que el microfilm no deja ver. Para una lectura fluida eso es una virtud; para una transcripción es el peor defecto posible, porque el error no parece un error.
La consecuencia es que esta colección sirve para orientarse, no para citar: localiza en qué hoja se habla de una elección o de una fiesta, y da la fecha, pero cada nombre debe cotejarse con la imagen antes de usarse.
Cómo se construye la capacidad que falta
Si el modelo ya aporta volumen, costo y contexto, y lo que le falta es la vista fina del paleógrafo, la pregunta es cómo se le enseña a ver. La respuesta de la bibliografía es conocida y modesta: un modelo de reconocimiento de escritura, como los de Transkribus, entrenado con unas cincuenta páginas de ese mismo libro corregidas a mano. Cincuenta páginas son dos o tres semanas de trabajo de una persona experta. A cambio, el modelo entrenado lee las 400 restantes y, en principio, cualquier otro libro de la misma mano.
Ese es el punto que me parece importante. La capacidad más que humana no sale de un modelo solo, ni de un paleógrafo solo. Sale de un sistema en el que la persona experta corrige poco y enseña mucho, y la máquina multiplica esa enseñanza por el tamaño del archivo. El paleógrafo deja de ser el cuello de botella de la lectura y pasa a ser el maestro de un lector que no se cansa.
Khronos está construyendo las piezas para eso:
- Una verdad de referencia. Páginas del Libro Once corregidas a mano, contra las que un segundo script mide la tasa de error de cada modelo, en lugar de fiarse de la legibilidad que el propio modelo se asigna.
- Un reparto de tareas honesto. El modelo de lenguaje se queda con lo que ya hace bien: fechar, clasificar, resumir y señalar qué hojas merecen el trabajo de un experto. La transcripción de nombres se delega a un modelo entrenado o a una persona hasta que la métrica diga otra cosa.
- Una comunidad que corrige. Nombres duplicados (Francisco de Ocampo Golfín y sus variantes siguen siendo nodos distintos en la red), lugares que el nomenclátor no reconoce, fechas mal leídas: lo sabe mejor quien trabaja con estas fuentes.
Qué cambia si funciona
Mientras tanto, lo que ya se leyó se puede recorrer. La interfaz es una aplicación React 19 con Vite y Tailwind, pensada para que cada vista cargue solo lo que necesita:
- Mapa. MapLibre GL sobre un mapa base oscuro, con burbujas agrupadas por lugar, un control deslizante de años con ventana ajustable y reproducción automática, y una ventana emergente con los registros de cada sitio.
- Cronología. Una lista con búsqueda insensible a acentos, filtro por década y carga incremental, para recorrer los registros en el orden en que aparecen en el índice.
- Red. Un grafo de coocurrencia: dos personas se conectan cuando aparecen en el mismo registro. Se puede ver a las más conectadas o explorar la red de una persona concreta.
Las tres vistas comparten el mismo detalle de evento y saltan entre sí; el idioma se recuerda entre visitas y el español es el predeterminado. Lo que sigue es deduplicar personas, ampliar el nomenclátor, enlazar cada registro con la página escaneada del tomo original y, con el tiempo, reconstruir árboles familiares a partir de las relaciones que el modelo ya extrae. El código sigue abierto en github.com/fabiomurillo-baset/khronos.
Si la capacidad se construye, el cambio no es que un libro se lea más rápido. Es que tres siglos dejan de ser un vacío por falta de lectores y pasan a ser un archivo consultable, donde una familia puede buscar su apellido, un pueblo su primera mención y un historiador la pregunta que todavía nadie ha hecho.
Participa
Un índice de 11 053 registros no se corrige ni se enriquece solo, y cincuenta páginas de verdad de referencia no se transcriben solas. Mucho de lo que falta —variantes de un mismo nombre, lugares que el nomenclátor no reconoce, fechas mal leídas, el vínculo entre un registro y la página escaneada del tomo— lo sabe mejor quien trabaja con estas fuentes: paleógrafos, genealogistas, historiadores locales, familias que conservan documentos. Por eso Khronos abre una comunidad en Discord, Historia Documental Costa Rica, pensada en tres niveles:
- Conversación pública. Comentarios, preguntas y correcciones a la vista de todos, para que cada hallazgo quede registrado y otros puedan sumarse.
- Aportes. Un foro donde cada publicación es un registro, una familia o un lugar, con sus documentos, fotografías y transcripciones adjuntos. Los aportes revisados se incorporan a los datos y el registro muestra quién lo enriqueció.
- Grupos de trabajo. Cuando un tema reúne a varias personas —una familia, un pueblo, un siglo— se abre un espacio propio para trabajarlo con más calma.
Únete al servidor en discord.gg/Hedm7gsH5. Las correcciones e ideas también son bienvenidas en el repositorio de GitHub.